Beispiele aus der Praxis
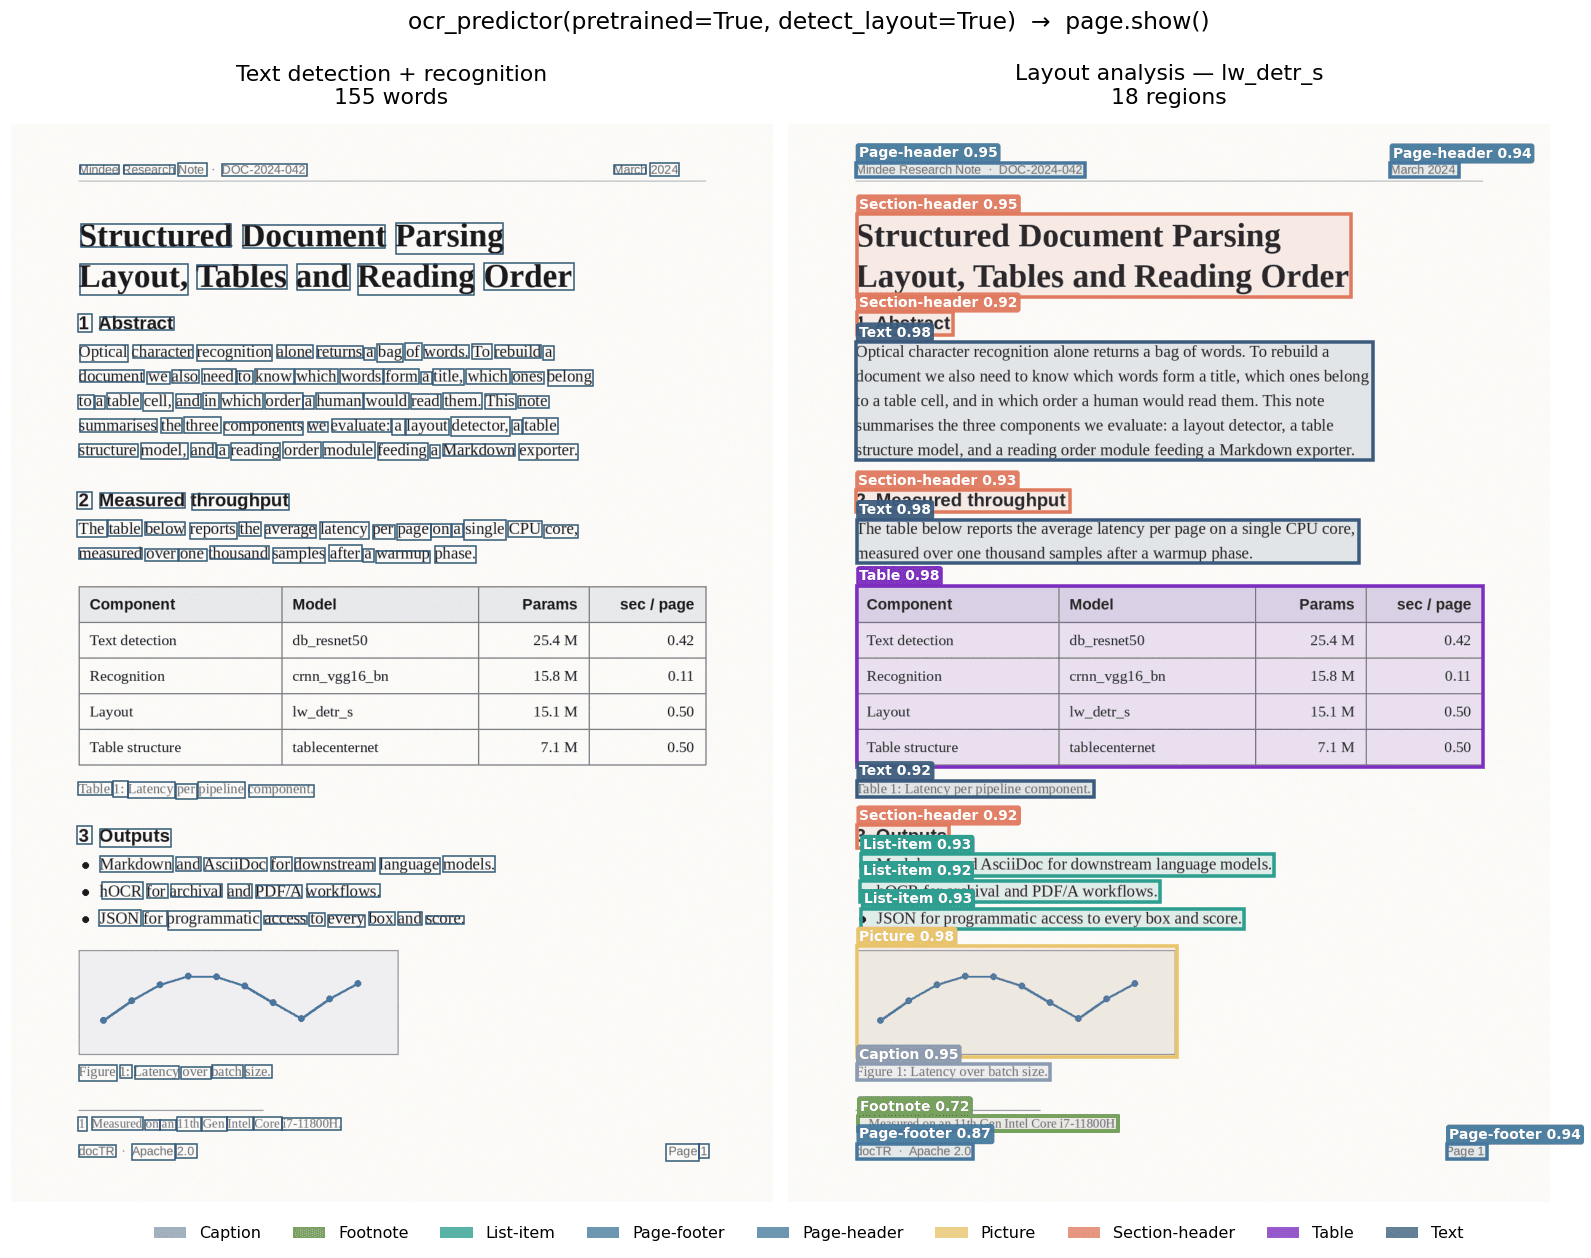
Erleben Sie docTR in Aktion: Die folgenden Screenshots zeigen die Pipeline in der Praxis – von der Layout-Erkennung in PDFs bis zur Texterkennung auf Fotos. Die Layout-Beispiele stammen aus docTR v1.1 mit dem lw_detr_s-Modell.
Layout-Erkennung in PDFs
Das LW-DETR-Modell erkennt elf Layout-Klassen – u. a. Title, Text, Table, Caption, Formula und List-item – und unterscheidet damit visuelle Struktur von reiner Worterkennung.
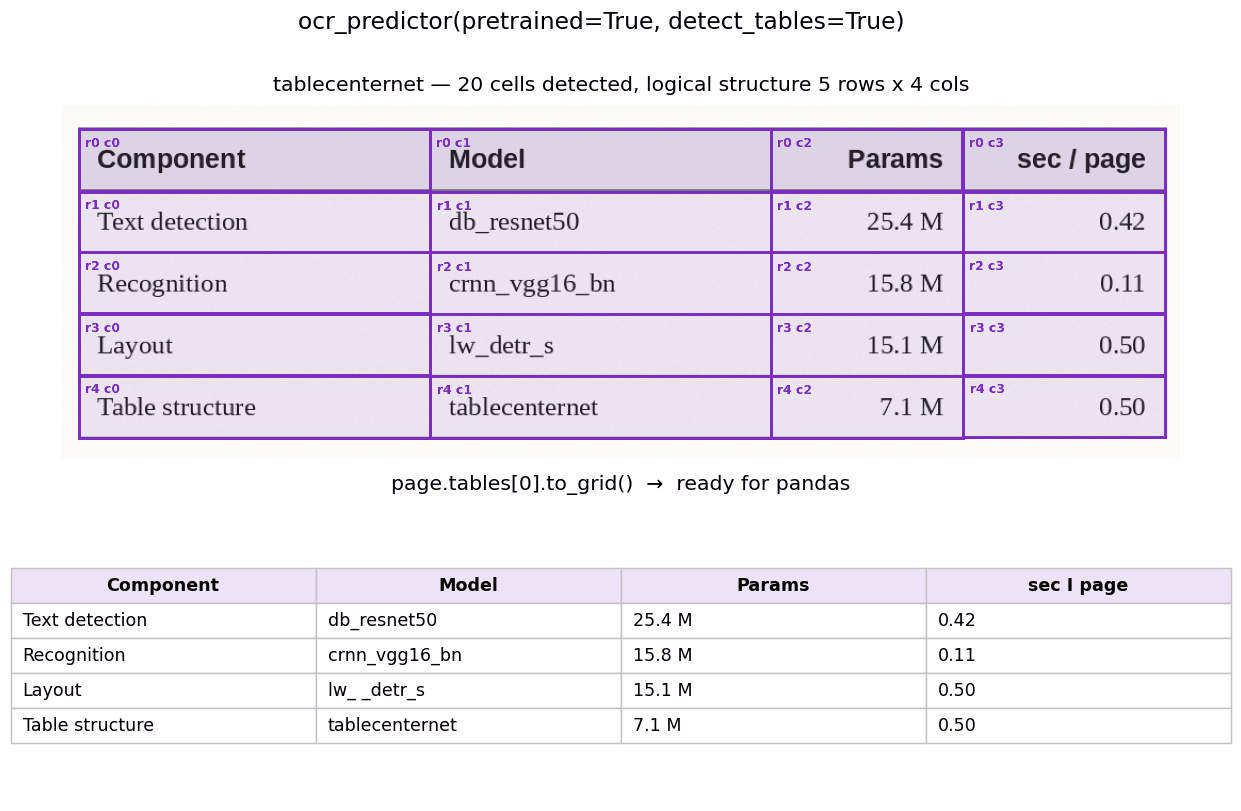
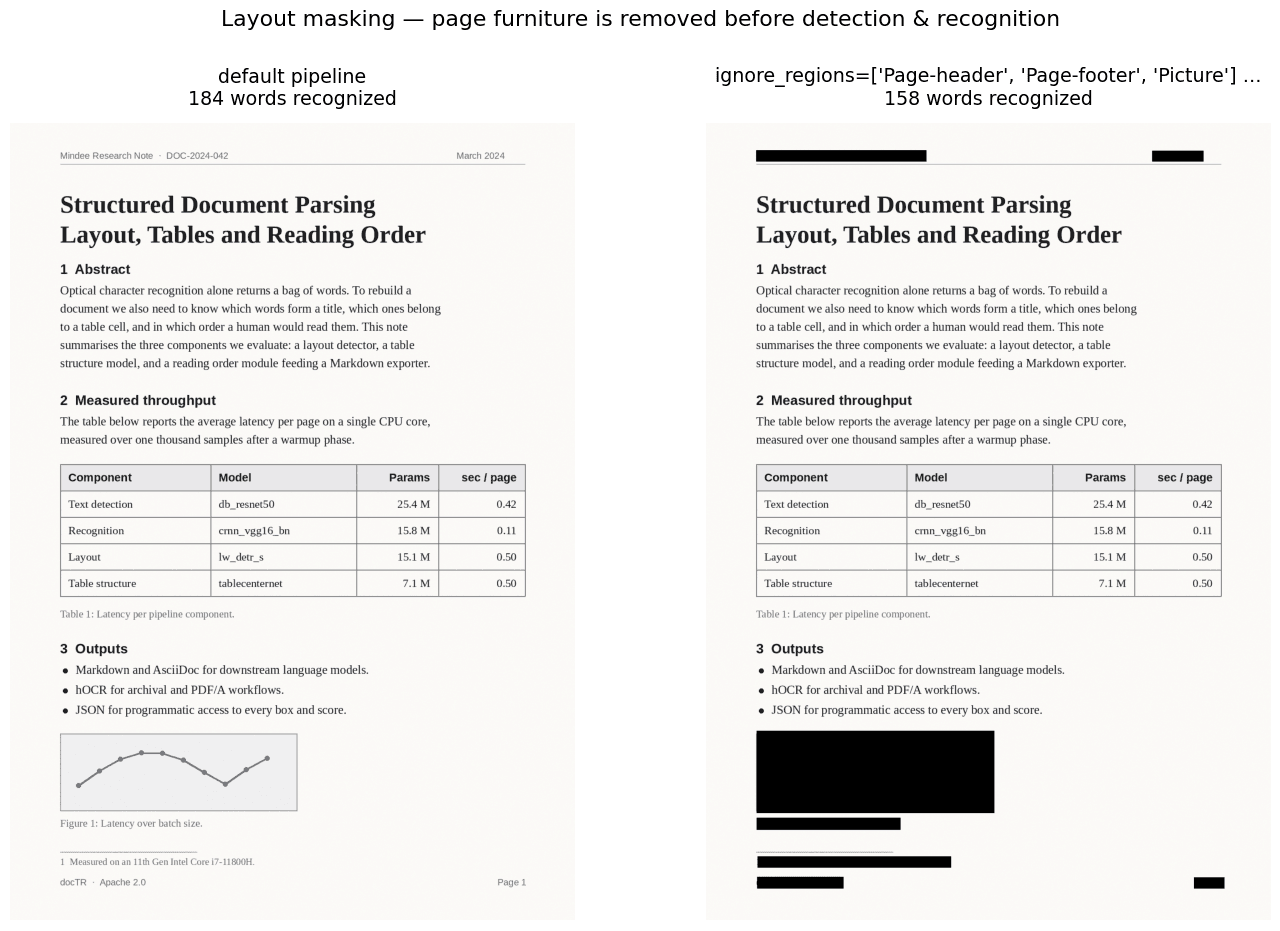
Zusammen mit Tabellenstrukturerkennung und Lesereihenfolge eignet sich docTR so für wissenschaftliche und technische PDFs – von der Layout-Analyse bis zur strukturierten Ausgabe.
Szenen-OCR auf Fotos
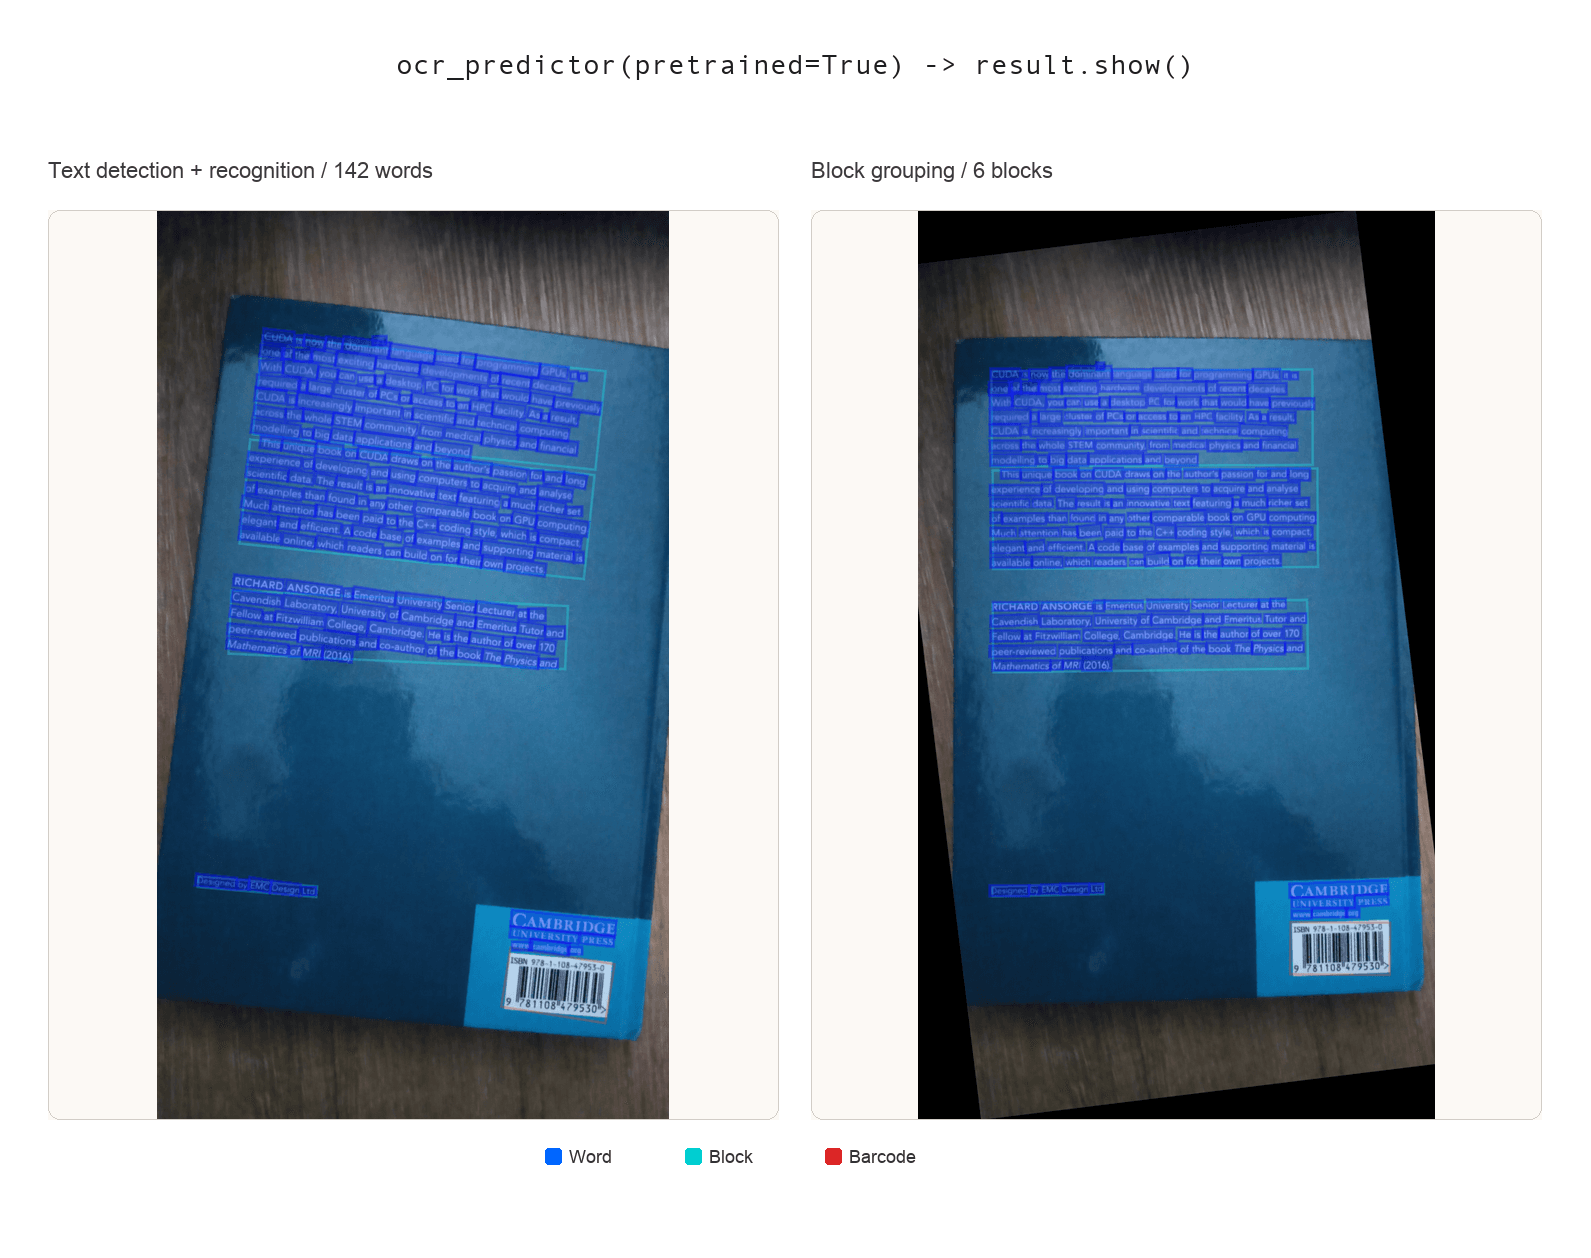
docTR ist nicht auf gescannte Dokumente beschränkt. Auf Fotos erkennt die Pipeline Text auf unebenen Oberflächen: von einzelnen Wörtern über Absätze bis hin zu speziellen Bereichen wie Barcodes. Auch mit Rotationen kommen die Modelle zurecht.
Open-Source-Modelle testen
Unsere Open-Source-Modelle und Informationen zur Implementierung finden Sie auf Hugging Face.
Bereit für OCR in Ihrer Infrastruktur?
Starten Sie mit einem Pilot in Ihrer Umgebung: Wir evaluieren die Performance auf Ihren Dokumenten und zeigen, was docTR On-Prem konkret für Ihren Use Case leistet – datenschutzkonform, kostenkontrolliert und vollständig unter Ihrer Kontrolle.
Oder rufen Sie uns direkt an: +49 (0) 351 27 51 97 74 · Mo.–Fr. 9–18 Uhr